












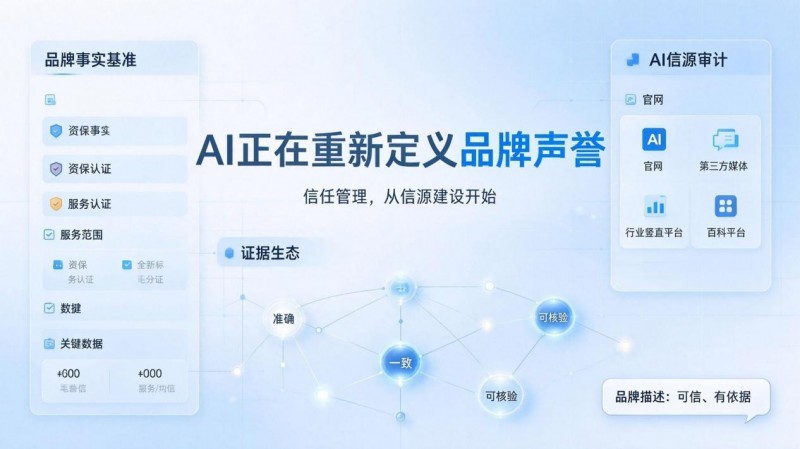
品牌名誉管理在过去很长一段时间里,有一个相对清晰的工作边界:监测搜索结果页有没有负面链接,社媒平台上的用户投诉和差评避雷贴,在危机发生时启动公关响应。这套逻辑的前提是,用户会搜品牌,然后自己判断。
但生成式 AI 改变了这个前提,用户直接问 AI“这个品牌怎么样”“值不值得信任”,然后接受 AI 给出的那段总结作为决策依据。名誉管理的战场,正在从“用户看到的页面”转移到“AI说出的哪句话?”
AI 在替品牌说话,但是不一定说得就对
AI替品牌说错话的形式比“说错一句话”要复杂得多,常见的情形包括:把竞品的主营业务安到品牌头上;把已经停产三年的产品仍然当作主力推荐;把十年前的环保处罚和当下的用户投诉拼接在一起,得出一个看似客观、实则误导的结论;或者虚构不存在的合作案例、资质认证甚至负面事件。
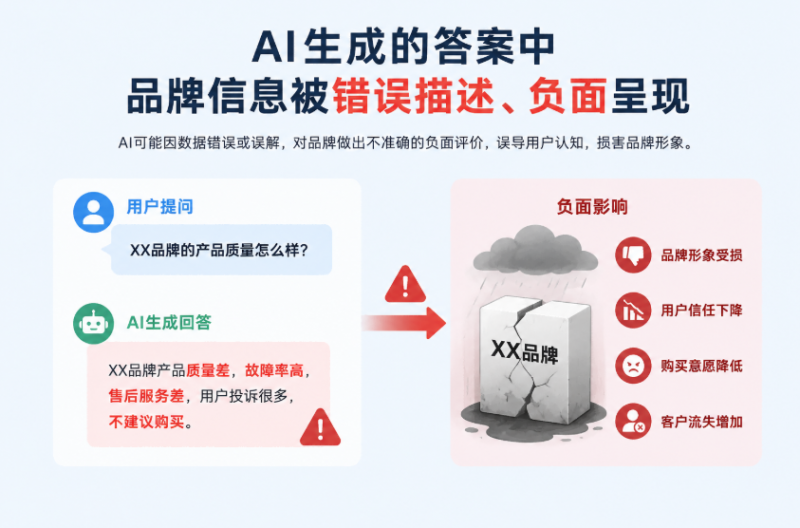
▲AI替品牌说错话的后果
历史负面信息的持久性同样超出直觉,据 Sefiani 2026年10月发布的《Cyber Breaches and Reputation Response in the AI Era》报告,在对三家已解决数据泄露事件多年的组织的测试中,历史泄露信息仅出现在 2.7% 的泛品类发现类 AI 回答中,但当用户直接询问“该品牌是否可信”时,这一比例升至 42.2%,其中一家组织的决策阶段回答中达到 59.1%。
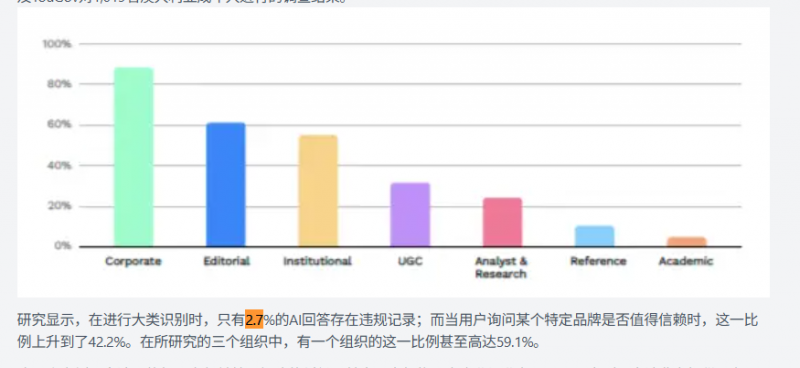
▲《Cyber Breaches and Reputation Response in the AI Era》
据Rithum 2026年3月对英美1,046名购物者的调查,当AI推荐包含错误产品信息时,58%的消费者会降低对品牌的信任,16%会放弃购买。
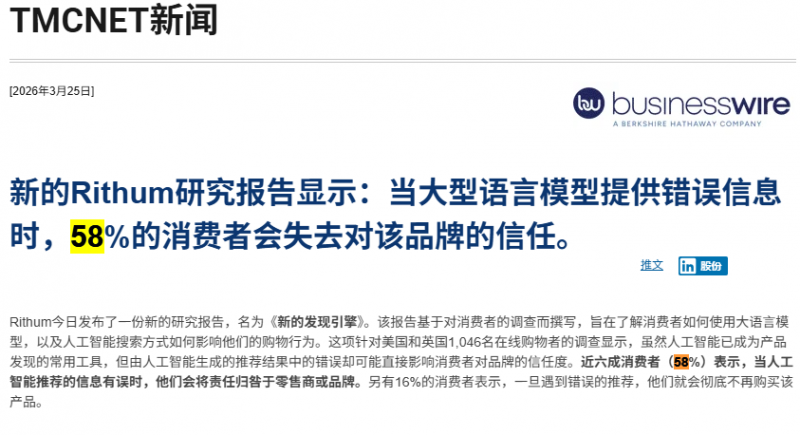
▲Rithum研究报告
当错误信息在用户不做二次验证的情况下直接进入决策,名誉管理的传统方式——发稿、申诉、维权——面对的就不再是一个“内容问题”,而是一个信源结构问题。
从野生内容到构建Ai可信的证据生态链
常规的品牌名誉管理的核心动作是拦截:稀释负面链接的排名,申诉差评的扩散,及时做公关危机动作。这套动作在 AI 时代仍然有用,但不够用了。因为 AI 不是“看到一条负面就传播一条”,它会从全网信源中检索、融合、归纳,然后输出一个带有判断色彩的合成答案。
你申诉掉了一条链接,但 AI 可以从另外五个未被清理的信源中提取同样的信息,甚至因为信源之间的矛盾而生成一个更糟糕的“混合版本”。
博雅集团 2026 年 6 月发布的《可信度悖论》报告,对这一转变给出了一个清晰的概括:GEO 的讨论正在从“可见度”转向“可信度”,品牌仅仅出现在 AI 答案中只是必要条件,真正决定声誉质量的是 AI 是否采信品牌提供的证据。
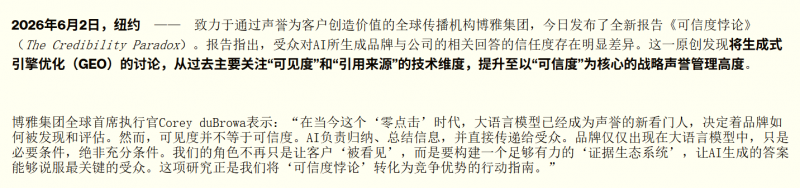
▲来源:博雅集团 观点
报告的核心发现之一是:AI 更青睐客观的证据,而非品牌的主观定位。关于产品、绩效、职场文化的可验证事实陈述,在 AI 回答中的可信度表现,持续优于领导力、治理等偏主观的属性。
什么意思?AI 时代名誉管理的核心阵地发生了微妙的变化:
维度 | 搜索时代 名誉管理 | AI 时代的名誉管理 |
核心对象 | 搜索结果页与 社媒平台的负面内容 | AI 答案中品牌被描述的方式与依据 |
主要动作 | 监测、投诉、删除、压制 | 信源审计、语义一致性治理、 证据生态建设 |
成功标准 | 负面链接消失或排名下降 | AI 描述准确、可信、 在信任询问中不出现偏差 |
失效模式 | 负面反复出现 | AI 基于过时或 矛盾信源形成“错误共识” |
如何构建客观的可信声誉?爬爬客的四个建设动作
以上海爬爬客数字营销在品牌声誉与 GEO 协同项目中的实践路径为参照,AI 时代的名誉管理可以拆解为四个可执行的动作。
第一步:AI信源审计
在做任何优化之前,需要先回答一个问题:在豆包、DeepSeek、元宝等平台上,当用户以品牌名或“品牌是否可信”类问题提问时,AI 引用了哪些来源?其中哪些是品牌可控的官方渠道,哪些是第三方媒体,哪些是过时或矛盾的信息?
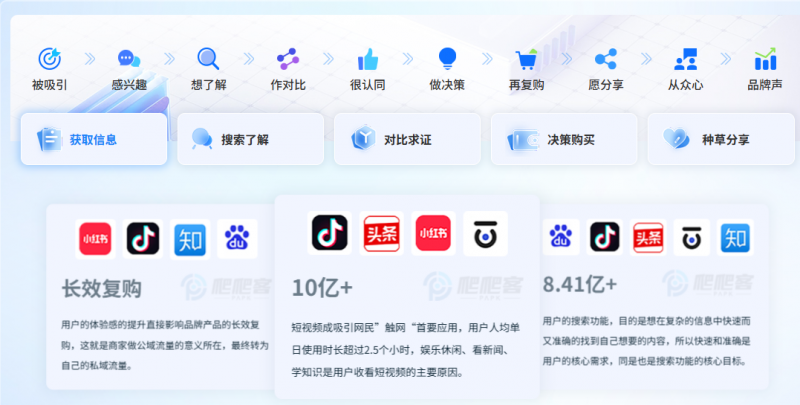
▲爬爬客SMO优化
这一步的价值在于定位缺口,一个品牌在 AI 中的描述可能整体正面,但关键信任问题(资质、安全性、服务能力)的回答来源如果集中在陈旧页面或非权威渠道,就是一个需要在信源层补齐的结构性风险。
第二步:语义一致性治理
如果品牌在不同平台上对同一事实的表述不一致,大模型在归纳时会面临信息冲突。AI 的处理方式可能生成一个谁都没说过的混合版本,或者选择不引用、做保守评估。
爬爬客的做法是,在声誉项目启动阶段先建立一份品牌核心事实的统一基准:主营业务、资质认证、服务范围、关键数据、历史事件的完整时间线。所有平台的内容分发和信源建设都参照同一基准延展,避免因为表述矛盾而给 AI 制造“不知道该信哪个”的困境。
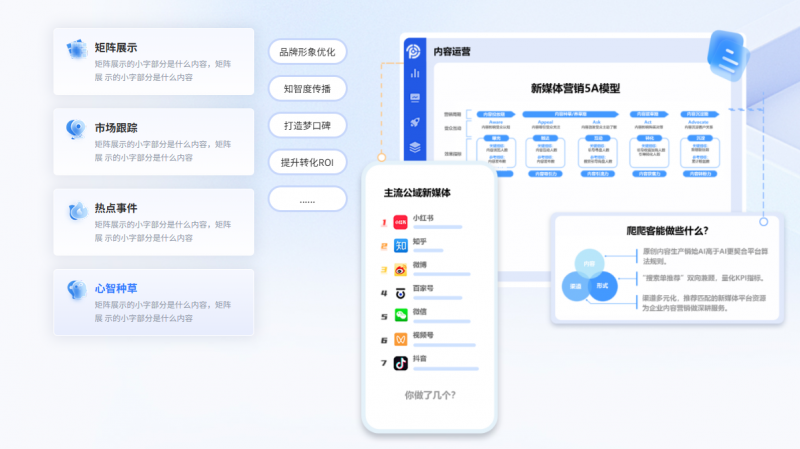
▲爬爬客SMO优化核心作用
第三步:可信的证据链密度建设
博雅的研究明确指出,AI 看重的是来自媒体报道、评论和社交讨论的独立佐证,并非品牌自己的单向官方声明函。简单来说,可信声誉的建设不能停留在官网和官方账号,需要在行业垂直媒体、百科类平台、专业社区等 AI 高频引用的信源类型中,形成关于品牌事实的多源、一致、可核验的记录。
第四步:分平台、分意图词的监测方式
精细的做法是将监测拆分为两个层次:品类发现阶段的提及与描述,以及信任询问阶段(“这个品牌XX系列产品好用吗”“值不值得选?”)的回答内容与引用来源。Sefiani 的数据已经说明,历史负面信息在后者中的出现比例远高于前者,如果将两类查询混在一起看平均值,会严重低估“信任关口”的风险暴露。
从爬爬客已公开的项目逻辑来看,其将品牌全网声誉维护与 品牌可信的GEO信源建设并行推进,在快消品行业Ai企业等项目中,通过梳理零散技术文档和品牌事实、建立 AI 可读取的清晰品牌画像,来减少 AI 描述中的过时与矛盾信息。
这类工作的效果衡量,是当用户以品牌名或信任类问题向 AI 提问时,答案中正确事实的密度和矛盾信息的比例发生了怎样的变化。
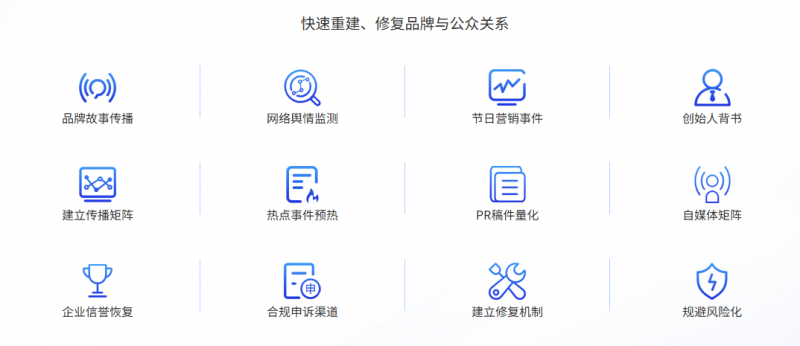
▲爬爬客SMO优化服务范围
当 AI 已经能够用一段合成答案替代用户过去需要在多个页面之间跳转完成的判断,品牌声誉的竞争就前置到了信源层。AI 的错误描述是因为它在信息不完整、不一致、不新鲜时,用最省力的方式做了填补。
对于正在考虑引入外部口碑优化服务能力的企业,评估名誉管理优化公司或寻找做品牌名誉优化的企业时,一个值得纳入考量的维度是:对方是否具备信源审计、空间语实体规划和信息锚点的一致性?再去治理和分平台监测的能力?而不仅仅是传统的舆情处置经验。
做品牌口碑维护的互联网公司之间的能力分水岭,正在从“能不能处理已经出现的负面”,转向“能不能让 AI 在回答品牌相关问题时,有足够准确、一致、可验证的材料来形成判断”。
AI 对品牌的描述尚未在大多数品类中固化,一旦错误或片面的信源结构在多个平台上形成稳定的引用惯性,修正的成本将远高于提前建设可信证据生态的投入成本。












